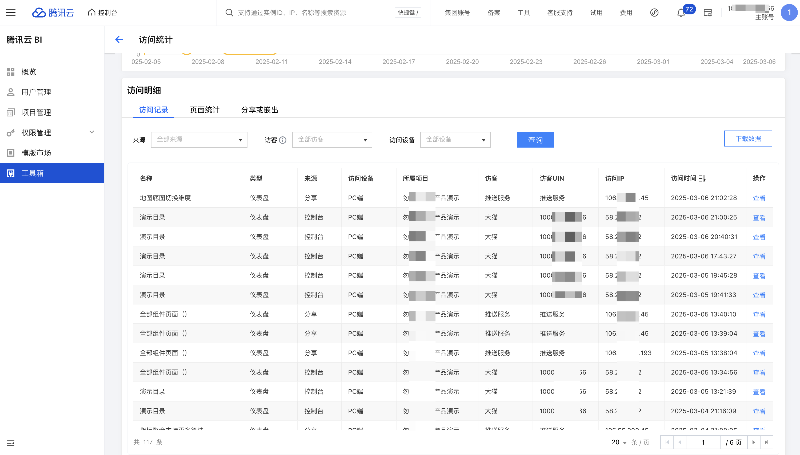
访问统计工具长期被误解为"装个代码看PV/UV"的轻量插件,但在数据驱动的运营体系中,它实际上是用户行为分析链路的第一道数据入口。工具采集的颗粒度、上报机制的可靠性、指标体系的完备性,直接决定了后续实时用户分析、用户生命周期分析与推荐效果监测能走多远。本文结合公开行业数据与典型实践,讨论访问统计工具在技术架构与分析价值上的演进逻辑。
一、从页面计数到事件模型:采集层的范式转移
早期访问统计工具以页面浏览为核心计量单位,典型实现是在页面加载时向日志服务器发送一条请求。这种模式在单页应用普及后迅速失效——路由切换不触发页面刷新,PV数据出现系统性低估。行业普遍的做法是转向事件模型:将曝光、点击、滚动深度、表单提交等行为抽象为带属性的结构化事件,通过统一SDK批量上报。
据公开的Web技术调研数据,目前主流站点中采用事件埋点与自动采集混合方案的比例已超过六成,纯页面计数方案占比持续下降。采集层的关键指标也随之变化:除了传统的访问量、独立访客数,还需关注事件上报成功率、端到端延迟与数据丢失率。某电商平台在其技术博客中披露,将上报机制从同步请求改为基于sendBeacon的异步批量队列后,移动端弱网环境下的数据丢失率从约8%降至2%以内,这直接改善了后续用户行为数据的完整性。
二、实时用户分析与流量统计的工程约束
实时用户分析对访问统计工具提出了流式处理要求。传统T+1离线统计难以支撑运营分析平台的即时决策场景,例如大促期间的流量突增识别、异常流量拦截、广告效果监测的分钟级归因。工程上通常采用"采集—消息队列—流计算—在线存储"的链路,指标聚合在窗口内完成。
需要强调的是,实时性与准确性存在权衡。流计算中的去重、会话切分、机器人流量过滤都会引入状态管理成本。行业实践表明,将实时指标定位为"趋势监测"、将精确统计交由离线批处理校准,是较为稳妥的分层策略。网站流量统计的口径定义因此必须显式声明:会话超时阈值、跨端去重规则、爬虫识别名单,任何一项变更都会造成指标断层,需要在数据字典中版本化管理。
三、访问统计数据如何支撑生命周期与体验分析
访问统计工具的价值不止于流量报表,它是用户生命周期分析的底层事实表。通过将访问行为按时间轴聚合,可以划分出新访、激活、留存、沉默、流失等阶段,并为每个阶段配置自定义行为分析规则。例如以"7日内完成核心行为≥3次"定义激活,以"连续30日无访问"定义流失预警,这些规则全部依赖统计工具提供的细粒度行为序列。
在用户体验分析维度,访问统计可输出页面停留时长分布、跳出路径、转化漏斗各环节流失率。结合推荐效果监测与广告效果监测的曝光点击数据,还能构建"流量来源—行为路径—转化结果"的归因视图。一个常见的误区是只看总量指标:某内容平台曾发现整体跳出率稳定,但分渠道拆解后,信息流渠道的跳出率显著高于自然搜索,问题定位到落地页加载性能,优化后该渠道转化率提升约15%。这类洞察的前提,正是统计工具具备维度下钻与自定义事件能力。
四、选型与治理建议
- 优先评估采集层的可靠性与可扩展性:是否支持事件模型、批量上报、弱网补偿、采样策略可配置。
- 确认指标口径可治理:会话定义、去重规则、机器人过滤均需文档化并支持版本追溯。
- 验证实时链路的延迟与降级方案,避免流计算故障导致运营分析平台整体不可用。
- 检查数据出口能力:能否以API或数据回传方式对接自有数仓,支撑用户行为数据的二次建模。
- 关注合规:访问统计涉及标识符与行为数据,需明确告知与最小化采集原则。
访问统计工具的技术水位,决定了用户行为分析体系的天花板。把采集做扎实、把口径管清楚、把实时与离线分层,工具才能从"看流量"升级为"看用户",真正服务于运营分析平台与体验优化的闭环。